
让科研回到实验室
线下科研 实地学习
同样是使用人工智能开展数据分析与项目开发,一部分工作可以得到严谨可靠、可复现的分析结果,能够直接应用在数据分析、代码开发、辅助科研等真实行业场景。但还有一部分工作受限于对模型原理的理解不足、提示词设计缺陷、数据校验缺失,产出的内容存在幻觉、逻辑漏洞,达不到实际使用标准。造成这种差距,不只是模型性能的问题,模型底层原理认知、数据分析思考逻辑、提示词设计、数据核查校验,还有真实项目开发的现实条件,都会很大程度影响最终输出质量。
想要做好人工智能与大语言模型相关研究,靠单一技术很难实现,需要把统计概率知识、机器学习理论、大语言模型原理、代码项目实践几类技术结合在一起。
大语言模型与机器学习实践技术,就是解决这些行业难题的重要方向。研究AI发展演进、统计概率基础、机器学习训练逻辑、大语言模型底层机制、云端与本地大模型部署、回归类模型选型对比等相关技术,可以帮助我们分清不同模型在生成逻辑、能力边界、适用场景上的差异。
围绕这个研究方向,本项目开设了AI背后的数学:基于统计建模的机器学习研究课程。学员结合人工智能领域真实遇到的难题,动手实操数据分析、Codex项目开发、网页开发调试,理解统计规律、模型参数、提示词策略如何影响AI输出结果,学会用科研的思考方式看待大模型与机器学习领域里的各类现实问题。
01学习前沿理论知识
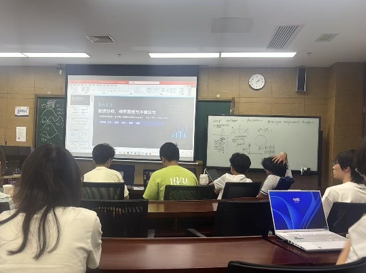
课程整体按照“人工智能与统计基础→机器学习训练与误差理论→大模型底层原理→云端本地大模型选型→模型选型与项目评估”这条主线循序渐进开展学习。
课程首先铺垫 AI 与统计基础,介绍 AI 发展、应用及向大模型演进的过程,区分监督、无监督学习与基础任务;讲解均值、概率、数据分布等统计知识,结合案例强调数据分析结论要有数据支撑,正视不确定性与模型局限。
随后学员们学习机器学习误差与训练流程,了解 MAE、MSE、损失函数、过拟合等概念,掌握数据输入、预测、算损失、更新参数的训练循环,重视数据质量校验,理解迭代优化思路。
接着学习大语言模型底层原理,认识 token、上下文窗口、温度参数,理解基于条件概率逐 token 生成文本的机制,了解 Transformer、预训练与对齐;知晓幻觉等缺陷,学会判断模型可靠性、编写高质量提示词。
在选取模型部分,课程对比云端和本地大模型差异,熟悉参数量、显存、推理速度等指标,根据数据敏感程度、硬件网络条件合理选型,理解轻量化模型的优势。
最后学习模型选型与项目评估,掌握几种回归模型的适用场景,遵循公平对比规范,做好测试集隔离、交叉验证,规避数据泄露,熟悉项目数据审计、对比、验收流程,形成完整项目研究思路。
02开展实践操作
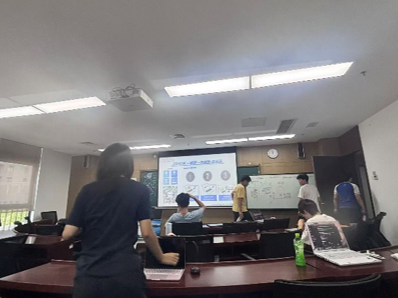
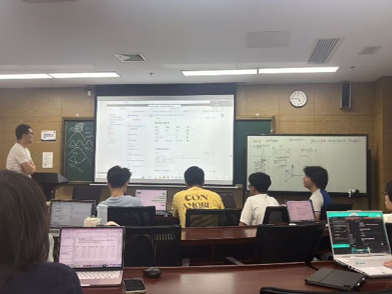
实践环节,学员围绕“统计数据分析实践‑机器学习训练流程模拟‑大模型Prompt实操‑Codex代码项目开发‑云端本地模型选型实验‑多模型对比与网页项目验收”开展系统训练。
项目初期,学员依托大模型做统计数据分析,使用天气、成绩案例练习概率和分布分析;对比不同大模型理科题作答效果并撰写报告,通过调优提示词提升结果准确性,同时养成标注数据局限、说明结果不确定性的习惯。
之后进行机器学习实操:借助 AI 查找公开数据集,用代码生成统计图并解读;完整跑通机器学习训练流程,核查数据来源、校验字段,排查数据和结论不一致问题,理解模型迭代优化过程。
在大模型原理与提示词实操中,学员们通过句子接龙、对照实验,直观理解 token、上下文窗口、温度参数对生成效果的影响;练习编写包含目标、素材、约束、输出格式的规范提示词,对比随意提示和规范提示的输出差异,使用三问法校验大模型回答是否可靠。
随后开展 Codex 项目开发:学员在限定离线环境中,依次完成材料核查、方案设计、代码编写调试,输出图表与报告;独立完成需求确认、项目搭建、测试排错和资料留存,做好数据审计,基于实验证据开发网页,同步记录测试过程。
选型和多模型对比实验阶段,学员根据硬件、网络、数据隐私需求选择合适的大模型;完成中位数基线、线性回归、决策树、随机森林四个模型的公平对照实验,严格执行测试集隔离、交叉验证,防止数据泄露,最终完成网页项目升级验收。
学员最后综合全部内容,对比不同提示词、模型、算法方案的输出效果,完整体验从数据分析、提示词工程、代码开发、多模型评估到项目验收的全流程。
03全面提升科研技能
本项目通过“理论学习‑代码与模型实操‑调试项目‑评估输出结果‑整理输出成果”的完整训练路径,帮助学员全面提升人工智能方向科研能力。
学员不仅学会统计数据分析、提示词编写、Codex代码项目开发、网页调试、多模型对比这些实操技能,还能明白大模型与机器学习研究,从弄懂底层原理到产出严谨可复现项目成果的完整流程。
学习过程中,学员需要不断思考现象背后的关联:如果缺少数据校验,会给AI分析结论带来哪些错误?提示词描述模糊会如何改变模型输出?本地与云端模型分别会对项目隐私、运行效率造成什么影响?模型对比过程中数据泄露会带来怎样的误导,该怎样设计对照方案验证自己的猜想。经过大量练习,学员养成“提出问题‑设计实验‑动手实操‑校验结果‑挖掘背后原理”的科研思维,懂得数据核查、对照验证、反复调试在人工智能研究当中的重要性。
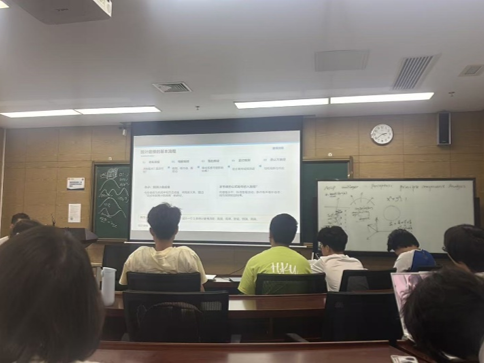
项目后期,学员需要整理数据集、项目代码、网页成果与实验现象,撰写项目报告,制作汇报PPT,参与结业答辩。锻炼阅读技术资料、分析模型输出缺陷、梳理项目逻辑、公开汇报表达的能力。
完成项目之后,学员可以系统理解AI发展脉络、统计概率基础、大语言模型运行机制、机器学习算法选型、本地与云端模型部署、AI辅助项目开发这些前沿技术,切身感受统计学、计算机科学交叉的研究模式,为之后钻研大模型应用、机器学习、AI辅助科研相关方向打下扎实基础。
04学员反馈
王同学:
通过这几天的课程学习,我对人工智能、大语言模型和数据分析有了更深入的了解。
课程让我认识到人工智能已经从早期的专用模型逐渐发展到如今的大语言模型,我也学习了监督学习、无监督学习、分类、回归等机器学习基础知识。同时,通过均值、标准差、概率和数据分布等内容,我对数据分析有了初步认识。
在学习大语言模型的过程中,我了解了Token、上下文窗口、Prompt以及模型生成文本的基本原理,也认识到AI并不是完全可靠的,可能出现知识过时或生成错误信息的情况。因此,在使用AI时不能只依赖它给出的答案,还需要自己进行思考、判断和验证。
我认为这次课程的安排比较合理,既有理论知识,也有实际操作,让我能够将课堂所学应用到具体任务中。授课老师讲解认真,能够通过实例帮助我们理解较为复杂的知识。
总体来说,这几天的课程让我收获很大,也让我对人工智能产生了更浓厚的兴趣。感谢老师们这几天的认真教学和帮助!